在日常办公与开发中,你是否也曾遭遇过这些棘手的困扰?
- 服务频频卡顿排队:线上大模型高峰期经常转圈报错,关键时刻卡在“正在思考中”,甚至提示“服务器繁忙,请稍后再试”;
- 敏感数据不敢上传:公司的核心业务代码、未公开的产品方案、财务报表或法律合同,根本不敢发给公有云 AI,生怕触犯保密红线导致商业机密泄露;
- 长期调用成本居高不下:多开几个高阶模型订阅,一个月大几百元的 VIP 费用悄然流失,按 Token 调 API 更是用得肉疼;
- 断网环境瞬间抓瞎:出差在高铁、飞机或涉密内网机房时,一旦没有外网连接,所有云端 AI 工具直接集体瘫痪。
如果现在告诉你:不需要复杂的环境配置,只需在终端敲一行命令,就能直接把顶级大模型完整下载到你自己的电脑里,即使拔掉网线、完全断网也能零延迟秒速回答,并且数据 100% 留在本机硬盘、永久完全免费——你会不会觉得这才是真正属于每个人的私有 AI?
今天为大家深度解析的,正是 GitHub 上狂揽 110,000+ Stars、被誉为本地 AI 基础设施之王的开源神作 —— Ollama!
 ▲ Ollama本地离线大模型神器
一、 Ollama 到底是什么?
Ollama 是一个开源的本地大语言模型运行与管理框架。它的最大价值,就是将原本极其高深、需要配置复杂 CUDA 驱动与 Python 环境的开源大模型,做成了像安装日常软件一样开箱即用的极简工具。
以往想在电脑本地跑一个 Llama 或 DeepSeek 模型,你需要手动下载动辄几十 G 的模型权重、安装 PyTorch、编译 C++ 依赖、调试 GPU 显存分配……99% 的普通用户直接被劝退在报错的第一步。
而 Ollama 彻底打破了这一门槛:
1. 全平台一键安装:支持 macOS(原生支持 M 系列芯片 Metal 加速)、Windows(完美调度 Nvidia GPU 或 CPU)、Linux;
2. 极简终端调用:像 Docker 管理容器一样管理大模型,想跑什么模型只需一条 ollama run 命令;
3. 硬件资源智能自适应:自动判断当前电脑的显存与内存大小,智能进行显存切片与量化,哪怕只有普通笔记本电脑也能流畅吐字!
二、 终端实测:一键跑满血 DeepSeek-R1
体验 Ollama 的过程简单到不可思议。安装完成后,你只需打开终端输入:
ollama run deepseek-r1:8b
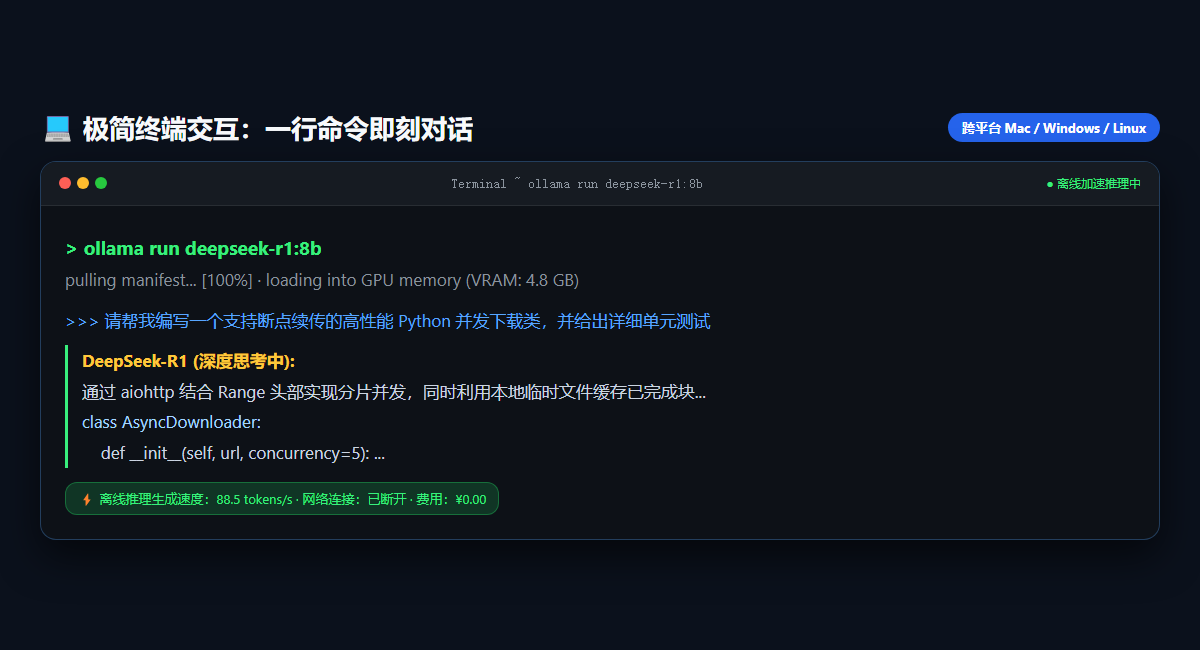 ▲ 终端一键运行实测
Ollama 会自动从官方开源模型库中拉取高精度量化权重,并在数秒内加载进显存,直接开启交互式对话窗口:
* 深度推理实测:向它提问复杂代码架构问题时,DeepSeek-R1 的完整思维链(<think> ... </think>)会在本地以每秒 80+ tokens 的惊人速度极速倾泻而出;
* 网络状态:完全断开 WiFi 与以太网,模型回答依然毫无阻滞;
* 硬件占用:轻量级 8B 版本仅需约 4.8GB 显存或内存,主流轻薄本均能从容承载。
除了 DeepSeek,Ollama 的模型库(Ollama Library)还收录了全球几乎所有顶级开源大模型,随取随用:
* 🧠 DeepSeek-R1 / V3:数学、逻辑与复杂推理天花板;
* 🦙 Llama 3.3 (70B / 8B):Meta 开源模型标杆,英文与通用问答极其扎实;
* ⚡ Qwen 2.5-Coder:阿里千问专为编程调优的代码生成利器;
* 👁️ LLaVA 1.6:本地离线看图识别、图表解析多模态大模型。
三、 为什么说本地私有化才是王道?
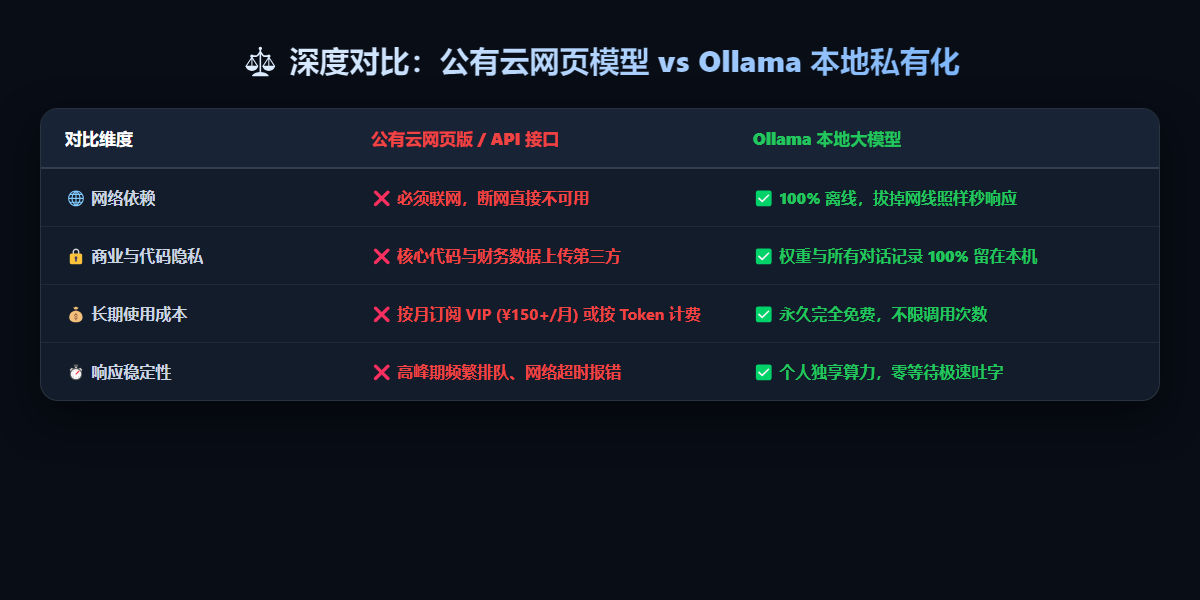 ▲ 公有云与本地私有化硬核对比
与传统的公有云网页版相比,Ollama 本地运行具备四大不可替代的硬核优势:
1. 🔒 100% 绝对的隐私与合规安全
所有模型权重、推理过程与聊天对话记录全部沉淀在你自己电脑的本地硬盘中,没有任何一条字节会回传到第三方服务器。涉密代码审查、敏感客户名单整理、核心财务测算,随时放心大胆处理。
2. 🌐 拔掉网线照样秒响应(完全离线)
出差飞行途中、高铁弱网环境、或是网络安全策略严苛的政企内部局域网,Ollama 都能稳定提供强力算力支撑,告别云端排队与服务器挤爆的尴尬。
3. 💰 彻底终结 API 账单与订阅费
零按月订阅、零 Token 计量费用,一次下载,终生免费使用,每天调用一万次也不花一分钱。
4. 🔌 丰富的生态无缝接入(OpenAI 兼容接口)
Ollama 在本地后台默认启动一个标准 REST API 服务(http://localhost:11434),并完全兼容 OpenAI 的接口规范。这意味着你可以一键将它接入到:
* ChatGPT 同款界面:配合 Open WebUI 或 Chatbox,立刻拥有私有化网页版 ChatGPT 体验;
* 知识库与智能体:无缝连接 Dify、FastGPT 构建企业内网知识库;
* 编程编辑器:在 VS Code 或 Cursor 中配置为本地代码补全引擎。
四、 极简三步上手指南
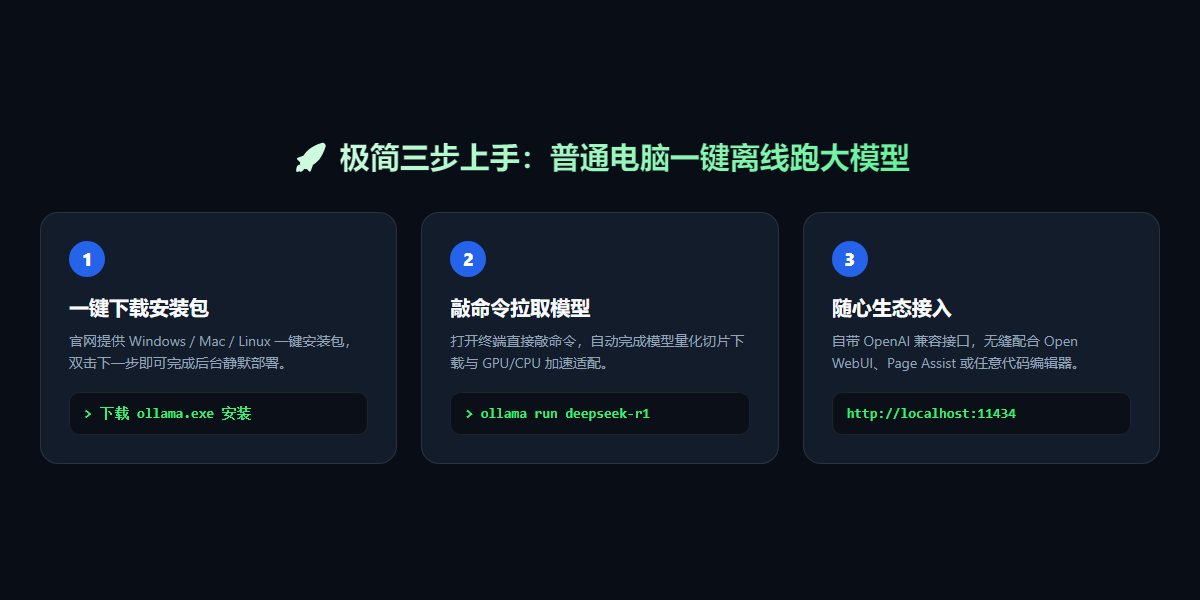 ▲ 极简三步上手指南
第一步:下载并安装客户端
前往官方主页或国内网盘镜像,下载对应操作系统的安装包,双击下一步即可完成后台常驻部署。
第二步:终端一行命令启动模型
打开命令行终端(Windows PowerShell 或 Mac Terminal),直接执行:
# 运行最新满血推理模型 DeepSeek-R1 (8B)
ollama run deepseek-r1:8b

# 运行代码神器 Qwen 2.5 Coder (7B)
ollama run qwen2.5-coder:7b
第三步:随心接入你喜欢的图形界面
如果你不习惯黑色终端窗口,只需在浏览器中搭配安装 Chrome 插件 Page Assist,或者本地 Docker 部署 Open WebUI,即可在熟悉美观的图形界面中与本地大模型畅快对话!
五、 项目资源与源码获取
Ollama 遵循 MIT 开源协议,完全免费开源,支持个人与企业商用。
总结:在数据资产越来越宝贵的今天,把大模型的主权牢牢掌握在自己手中,不仅是一种极客追求,更是未来数字生产力的安全底座。Ollama 让每一个普通人都能零门槛拥有专属的离线数字大脑,强烈推荐每一位追求效率与隐私的朋友亲自安装体验!
