导读与痛点剖析:
你是不是也这样,自己满心欢喜搭建了一个企业 AI 知识库,把精心整理的几十页财务报表、技术手册、多栏学术论文或扫描版合同丢进去,结果提问时大模型不仅答非所问、漏掉核心数据,甚至一本正经地胡说八道?
别再用传统落后且粗暴的“固定字数文本切片(Naive Chunking)”了! 文本一旦被切得稀碎,表头与数据行分离、多栏混淆错乱,即使接入最强的满血大模型,出来的也是一堆垃圾答案!
今天为大家带来一款在 GitHub 上狂揽 32,000+ Stars 的现象级开源 AI 神器——RAGFlow!它基于深度的多模态文档理解技术,彻底重构了 RAG 检索生成与知识库的底层生态,真正实现了 100% 零幻觉、可精准溯源、开箱即用 的下一代企业级知识库与智能体工作台!
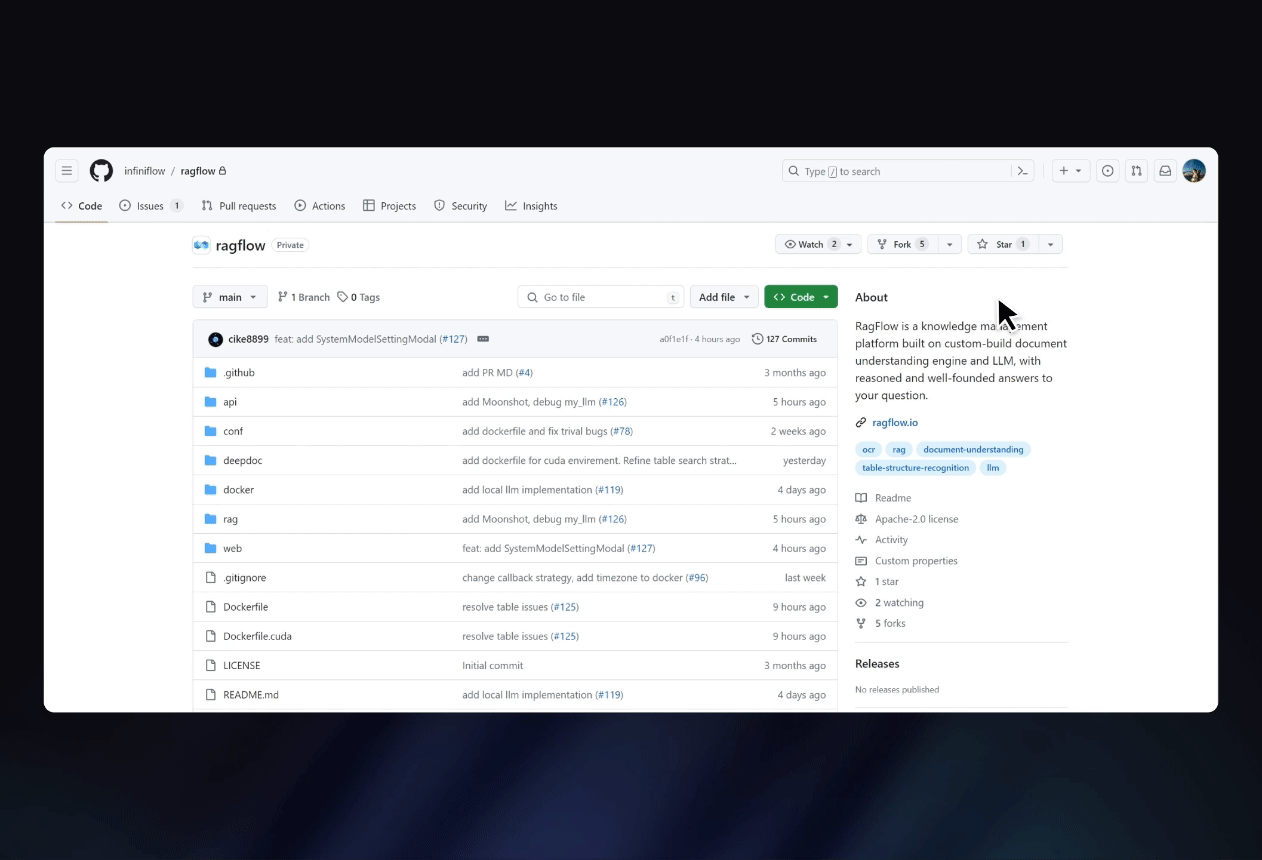 ▲ RAGFlow 知识库总览与文档智能管理界面
一、 为什么传统知识库频频翻车?RAG 技术的终极破局者
在检索增强生成(RAG)领域,很多团队误以为“搭知识库 = 文本切块 + 存向量数据库 + 调大模型 Prompt”。但在实际工业级场景中,绝大多数文档都是复杂排版格式(如带合并单元格的 Excel/财报、双栏排版的学术论文、带印章与复杂签名的扫描件 PDF)。
传统切块工具只会机械地每隔 500 个字符截断一次:
1. 表格结构碎成渣:原本完整的“2024Q3 研发费用 14.8 亿”,表头在 Chunk A,数值在 Chunk B,大模型检索时根本无法建立关联;
2. 多栏排版大错乱:左右分栏的文章被横向按行扫描,左右两句话混成一段天书;
3. 黑盒检索无从考证:大模型给出了一个貌似正确的答案,但你根本不知道它是从哪页哪行算出来的,无法用于严肃商业合规决策。
RAGFlow(infiniflow/ragflow) 的诞生,正是为了解决这一致命缺陷!它不仅完全开源(Apache 2.0 协议),更开创性地提出了 “Garbage in, Garbage out”(垃圾进,垃圾出) 的工程治理理念——唯有做好多模态端到端的深度文档理解,才能从源头上根除 AI 幻觉!
 ▲ RAGFlow 核心系统架构与 DeepDoc 深度文档解析引擎
二、 核心黑科技拆解:RAGFlow 的五大杀手锏
1. 自研 DeepDoc:多模态视觉版面分析与复杂表格还原
RAGFlow 并没有依赖简单的文本提取库,而是内置了自研的 DeepDoc 深度视觉文档解析引擎。
– 视觉版面识别:在提取文本前,先通过类似视觉大模型的对象检测算法,精准识别页眉、页脚、标题层级、双栏/三栏正文、插图及表格边界;
– 复杂表格完美重构:对于跨页表格、合并单元格,DeepDoc 能精准提取其三维关系,将表格解析为结构化的 HTML / Markdown 语义单元,确保行与列的语义永不丢失!
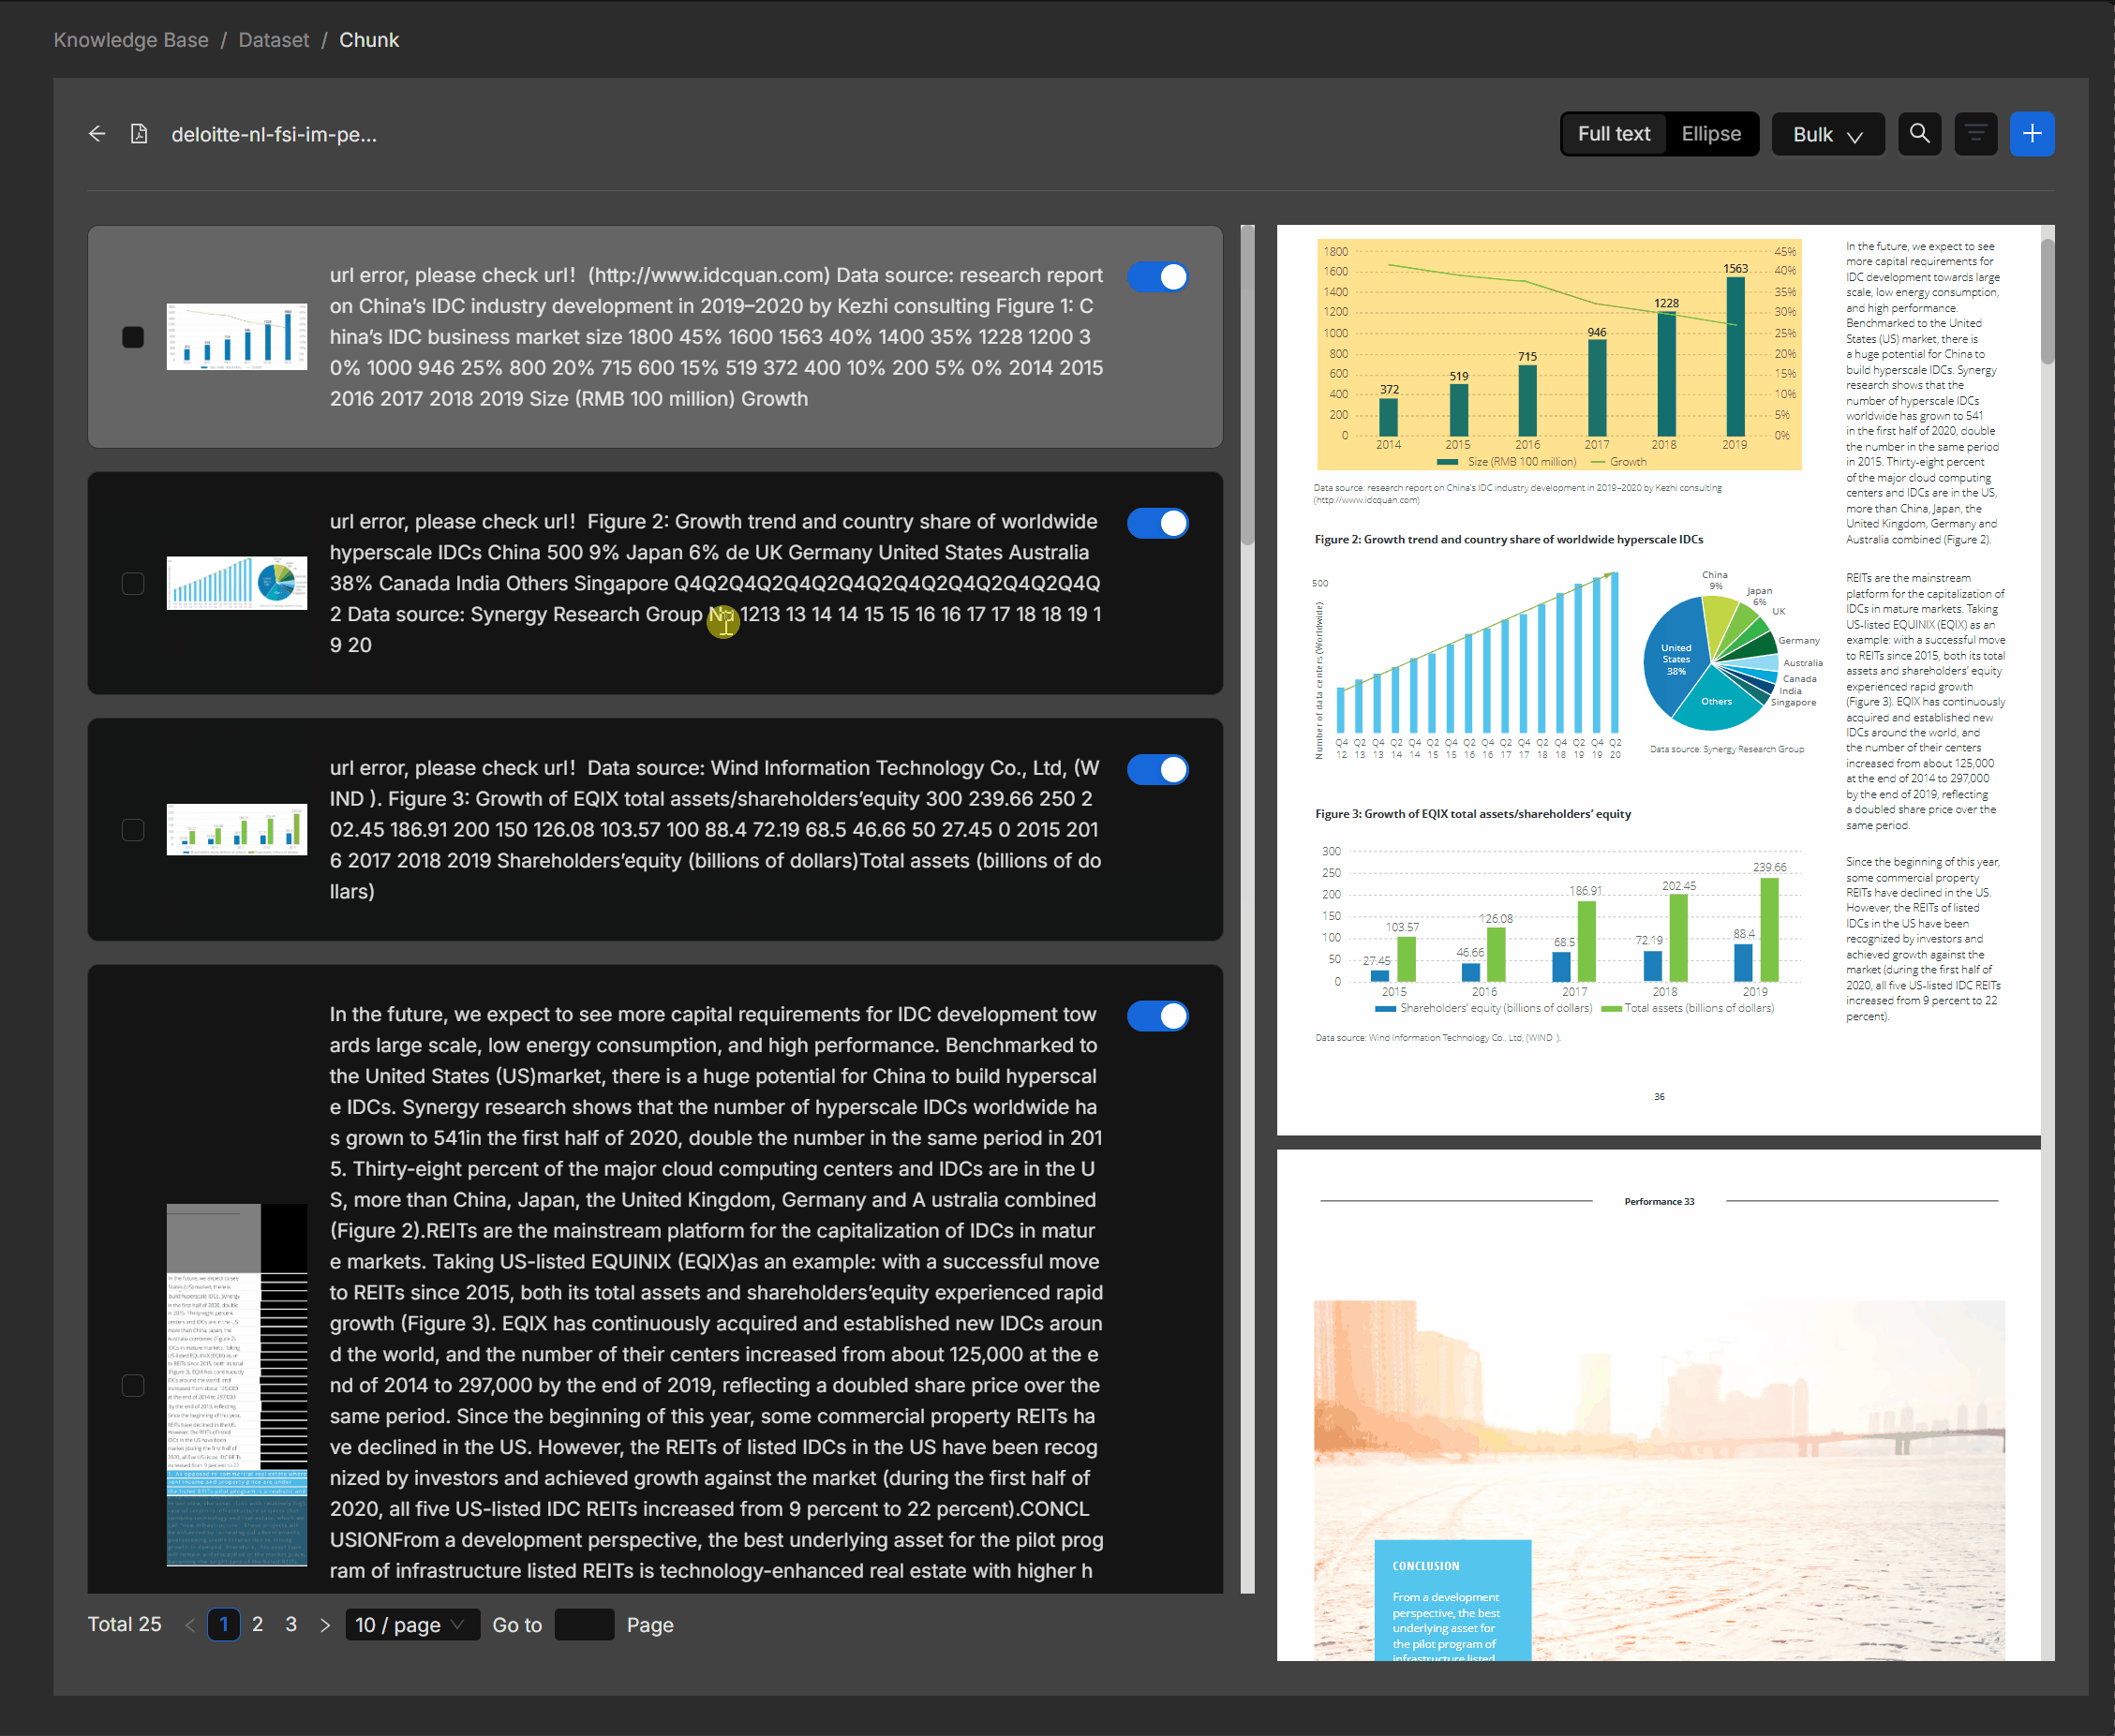 ▲ DeepDoc 智能模板分块与表格可视化预览
2. 场景化“智能分块模板”矩阵(拒绝盲目一刀切)
不同格式的文档,理应采用完全不同的处理逻辑。RAGFlow 在后台提供了极其丰富的切片解析模板:
– 📊 Table(表格专精):专为财务报表、统计台账打造,保证每一行数据都绑定完整表头上下文;
– 💬 Q&A(问答模板):自动提取文档中的高频问答对,适合企业客服库与故障排查手册;
– 📑 Manual(技术手册):自动按照章节层级树(H1 -> H2 -> H3)进行递归聚类;
– 📄 Paper(学术多栏论文):精准消除换行与分栏跨列阻断;
– 📚 Laws & Regulations(法律法规):严格按“编、章、节、条、款”规范切分。
3. 多路混合检索:稠密向量 + 稀疏全文检索
很多知识库只用 Embedding 向量检索,遇到生僻专有名词、产品型号代码(如 S-300-X)时命中率极低。
RAGFlow 采用多路混合检索架构(Hybrid Search):
– Dense Retrieval(稠密向量):理解语义相似度,捕捉跨语言与同义表达;
– Sparse Retrieval(全文关键词 / BM25):保证专有型号、时间节点、核心指标 100% 精准召回;
– 重排序模型(Reranker):对混合召回的候选片段进行第二轮交叉注意力重排,将最相关的精准证据排在最前面!
4. 真正 100% 可解释:双屏对照与原文高亮标红溯源
在严肃政企业务中,“答案可解释性”是最高铁律。
RAGFlow 在对话交互界面中,右侧无缝嵌入了原始 PDF/文档预览器。当大模型输出结论并附带引用角标时,鼠标轻轻悬停,右侧画面立刻自动滚动至原始文件对应页码,并将引用的段落与表格原封不动高亮标红!
“从哪里来、说了什么、数据是否属实”,一目了然,彻底消除领导和客户的信任危机。
 ▲ RAGFlow 智能对话与原文高亮溯源标红
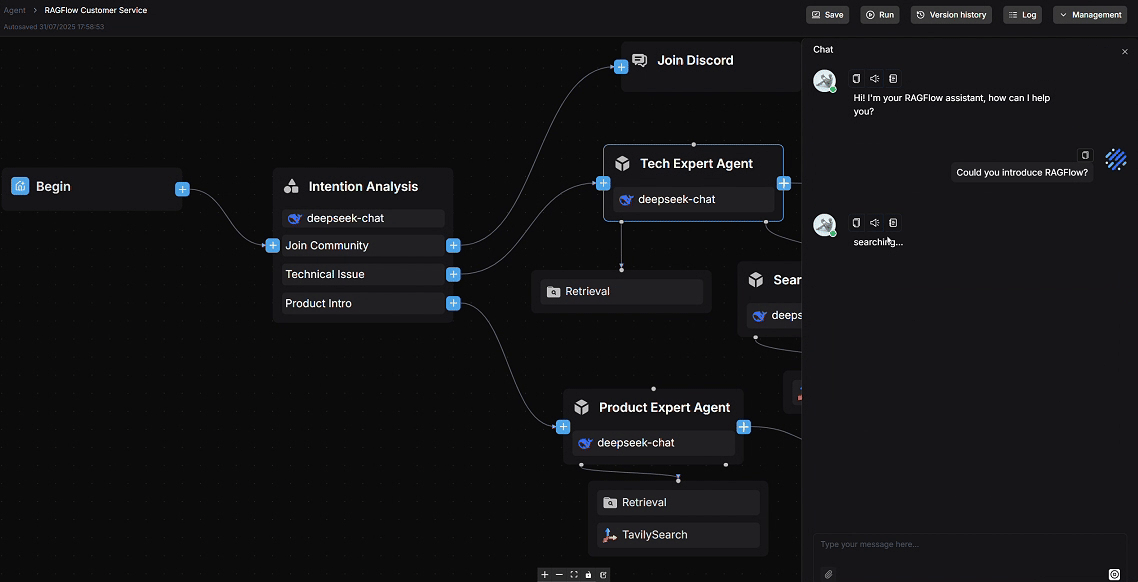
5. 可视化 Agent 画布编排:从知识检索跃迁到自主执行
不仅是知识库问答,RAGFlow 全面集成了类似 Dify / ComfyUI 的可视化 Agentic 智能体画布!
– 自由拖拽:输入、大模型推理(支持满血 DeepSeek-R1、Ollama 本地大模型)、知识库检索、Python 代码执行器、HTTP 外部 API、条件分支等多种节点;
– 能够构建“查研报 -> Python 提取表格数据 -> 自动计算财务比率 -> 格式化输出分析报告”的全自动端到端业务闭环!
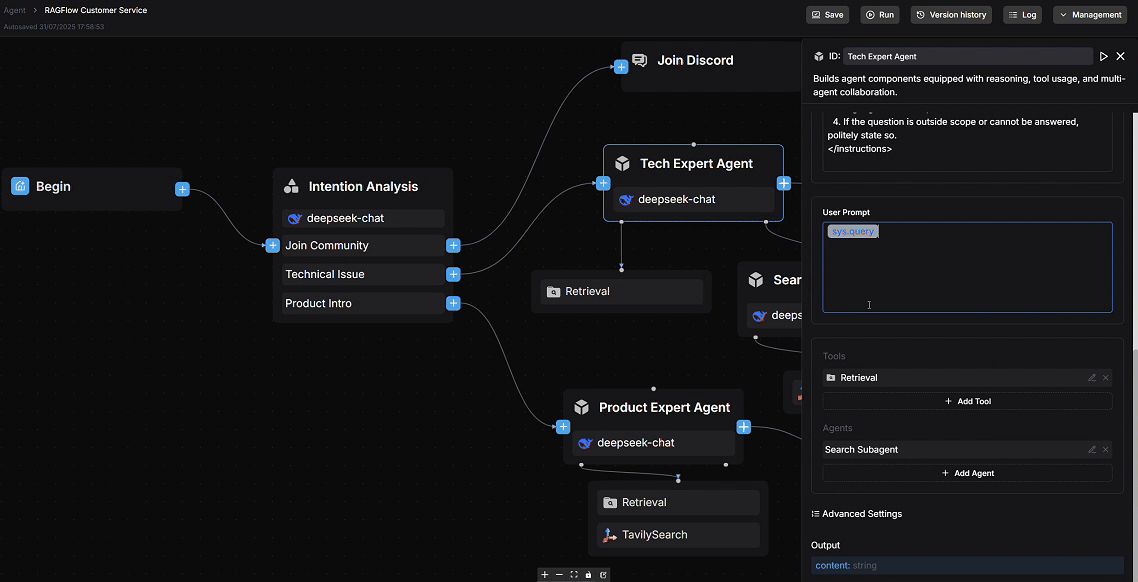 ▲ RAGFlow 可视化 Agent 智能体编排画布
三、 硬核横评:RAGFlow vs FastGPT vs AnythingLLM vs Dify
| 对比维度 | RAGFlow | FastGPT | AnythingLLM | Dify |
|---|---|---|---|---|
| 开源协议 | Apache 2.0 (商业友好) | AGPL / 商业授权 | MIT | Apache 2.0 |
| 核心专注点 | 深度文档理解与零幻觉RAG | 快速知识库问答构建 | 桌面轻量级私有助手 | 全栈综合性 LLM 应用平台 |
| 复杂表格与多栏解析 | 极强 (自研DeepDoc视觉版面) | 依赖通用切片/外部解析 | 基础文本抽取 | 依赖通用切片与插件 |
| 智能分块模板 | 支持Table/Q&A/Manual等数十种 | 基础分块与QA拆分 | 固定Token切分 | 通用分块与清洗规则 |
| 原文可视化标红溯源 | 原生支持 (双屏高亮定位) | 文本片段卡片展示 | 文本片段引用 | 文本片段引用 |
| 内置 Agent 画布 | 支持原生节点式拖拽编排 | 支持基础连线流程 | 不支持 (纯对话) | 极强 (功能完善) |
| 私有化与本地模型支持 | 支持 Docker / Ollama / 本地API | 支持 Docker | 桌面一键安装 / 本地离线 | 支持 Docker |
选型建议:
– 如果你的核心业务场景是分析海量复杂文档、研报、财报、合同及图纸,且对问答准确率与证据溯源有严苛要求,RAGFlow 毫无疑问是当下的第一梯队首选!
– 如果侧重轻量桌面随手记笔记,选 AnythingLLM;如果侧重通用 SaaS 应用搭建,选 Dify。
四、 5分钟 Docker Compose 极速本地私有化部署实操
RAGFlow 官方提供了极度完备的 Docker 化部署脚本,支持跨平台(Windows / Linux / macOS)一键拉起。
1. 硬件环境推荐要求
- CPU:$\ge 4$ 核(推荐 8 核以上进行高效 OCR 与文本特征提取)
- 内存:$\ge 16\text{ GB}$ RAM(运行内置 Elasticsearch / Infinity / OCR 模型)
- 磁盘:$\ge 50\text{ GB}$ 可用 SSD 空间
2. 极速拉取与启动命令
在终端中执行以下标准指令:
# 1. 克隆官方最新代码仓库
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker

# 2. 启动基础核心镜像群(包含 Web 前端、后台服务、向量索引引擎等)
docker compose up -d
启动完成后,打开浏览器访问本地端口:
👉 http://localhost:80(或你的服务器 IP)
3. 配置满血 DeepSeek 或本地 Ollama 模型
- 进入系统设置页面的 Model Providers(模型提供商);
- 选择 Ollama:填入本地地址
http://host.docker.internal:11434,即可调用本地已经拉取的离线模型(如deepseek-r1:7b、qwen2.5:7b); - 也可以选择直接填入 DeepSeek / OpenAI / SiliconFlow 官方 API Key,秒级开启满血大模型推理!
五、 总结与全套实战资源包领取
RAGFlow 真正把企业级知识库从“玩具式玩具问答”拉升到了“工业级精准交付”的新高度。它告别了华而不实的虚假参数,用扎扎实实的视觉解析、智能分块和多路混合检索,为所有被 AI 幻觉困扰的开发者与团队提供了一把破局利器!
为了让大家少走弯路,我们已经将:
1. RAGFlow 最新版 Docker 一键启动整合包(预置中文 OCR 权重与优化配置);
2. 5 套官方推荐的标准智能分块演示案例文档(财报、论文、问答与手册);
3. 从零到一构建高精度企业客服 Agent 的全流程实操 SOP;
全部为大家整理打包完毕!
👉 在本文下方评论区留言【工具】,即可免费获取完整源码地址与保姆级实操网盘资源!
