【一天一个强大的工具】只用5秒录音克隆声音?狂揽4.5万星的开源语音克隆神作:GPT-SoVITS保姆级深度实操与部署全解
导读:自媒体配音还在花大几百开会员?商业配音软件要么机械电音浓厚、毫无情感起伏,要么动辄按字计费、强制将私人语音数据上传云端?今天我们要深度拆解的,正是 GitHub 上狂揽 4.5 万 Stars、彻底颠覆全球语音合成格局的神级开源项目——GPT-SoVITS!仅需 5 秒的人声样本,AI 就能 1:1 复制你的音色、语气甚至呼吸声,支持中英日粤跨语种自由切换,完全免费且支持纯本地离线运行!
一、GPT-SoVITS 是什么?为什么能火遍全球技术圈?
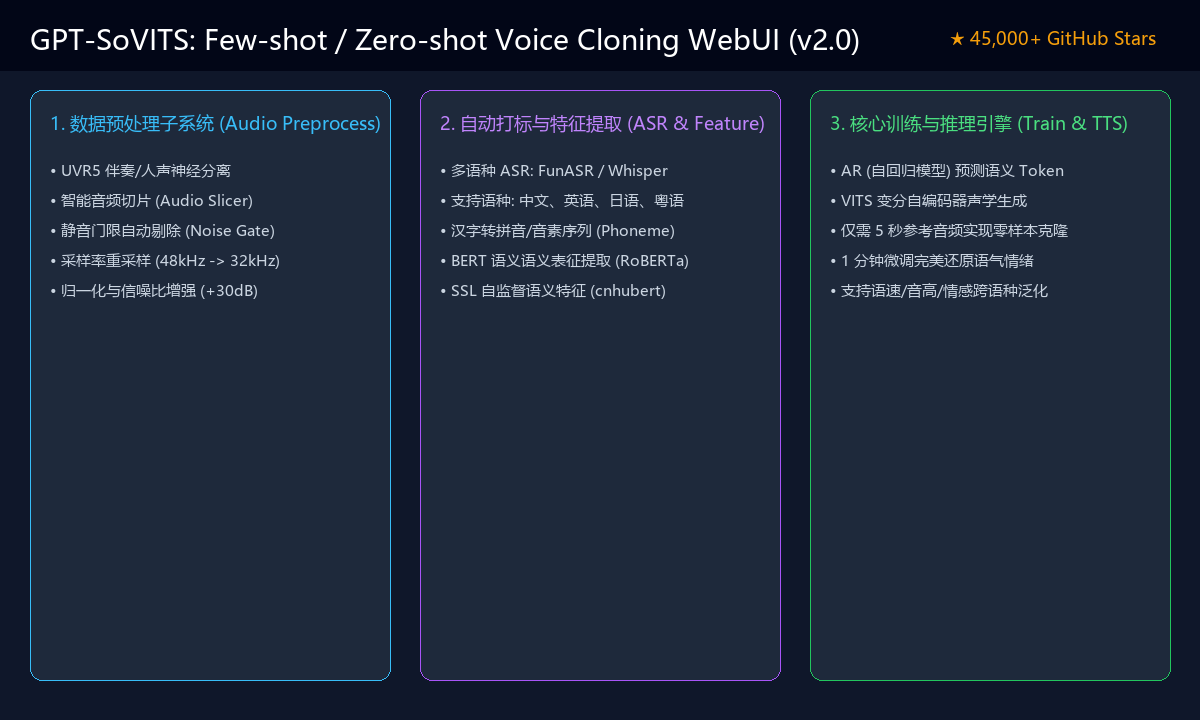
GPT-SoVITS 是由开源开发者 RVC-Boss 团队主导研发的强大的跨语种少样本/零样本语音克隆与文本转语音(TTS)开源框架。
在它诞生之前,传统的个性化声音克隆技术有着难以逾越的门槛:要么需要至少数小时的高保真录音棚级纯净干音,要么需要耗费巨额算力在集群上训练数天;而市面上所谓的商用“AI克隆”平台,不仅收费昂贵,还存在严重的隐私泄露风险。
GPT-SoVITS 彻底打破了这一垄断:
1. 零样本克隆(Zero-shot TTS):只需提供一段 5 秒的参考音频,模型即可直接提取声学特征并合成任意目标文本;
2. 极小样本微调(Few-shot Fine-tuning):仅需 1 分钟的语音数据进行极速微调,即可完美还原目标人物细致入微的语气、情绪变化与口音习惯;
3. 跨语种合成:即使你只给了一段中文录音,AI 也能用你的专属音色流利讲出英语、日语甚至是粤语!
                     ┌──────────────────────────────────────────────┐
                     │          GPT-SoVITS 核心两阶段声学生成架构     │
                     └──────────────────────┬───────────────────────┘
                                            │
               ┌────────────────────────────┴────────────────────────────┐
               ▼                                                         ▼
    ┌───────────────────────────┐                             ┌───────────────────────────┐
    │    第一阶段:AR 自回归模型  │                             │   第二阶段:VITS 声学生成  │
    │ (自回归预测语义 Token 序列) │ ─── 隐空间语义 Token 映射 ───▶│ (变分自编码器还原高保真波形)│
    │ 捕捉文本语调、停顿与情感韵律│                             │ 48kHz 无损重采样、消除机械感│
    └───────────────────────────┘                             └───────────────────────────┘
官方核心指标与开源档案:
- GitHub 开源项目:
RVC-Boss/GPT-SoVITS - GitHub Star 数:🔥 45,000+ Stars (4.5 万+)
- 开源协议:MIT License 商业友好开源
- 核心特性:5 秒 Zero-shot 克隆、1 分钟 Few-shot 训练、中英日粤跨语种、UVR5 神经降噪、FunASR/Whisper 智能打标
- 支持平台:Windows 10/11(提供免配置一键整合包)、Linux、macOS
二、四大核心功能模块实操拆解
步骤一:音频切片与智能降噪(内置 UVR5 人声伴奏分离)
在声音克隆任务中,“垃圾进,垃圾出”是铁律。干净、清晰的人声切片是模型音色还原度达到 99% 的绝对前提。
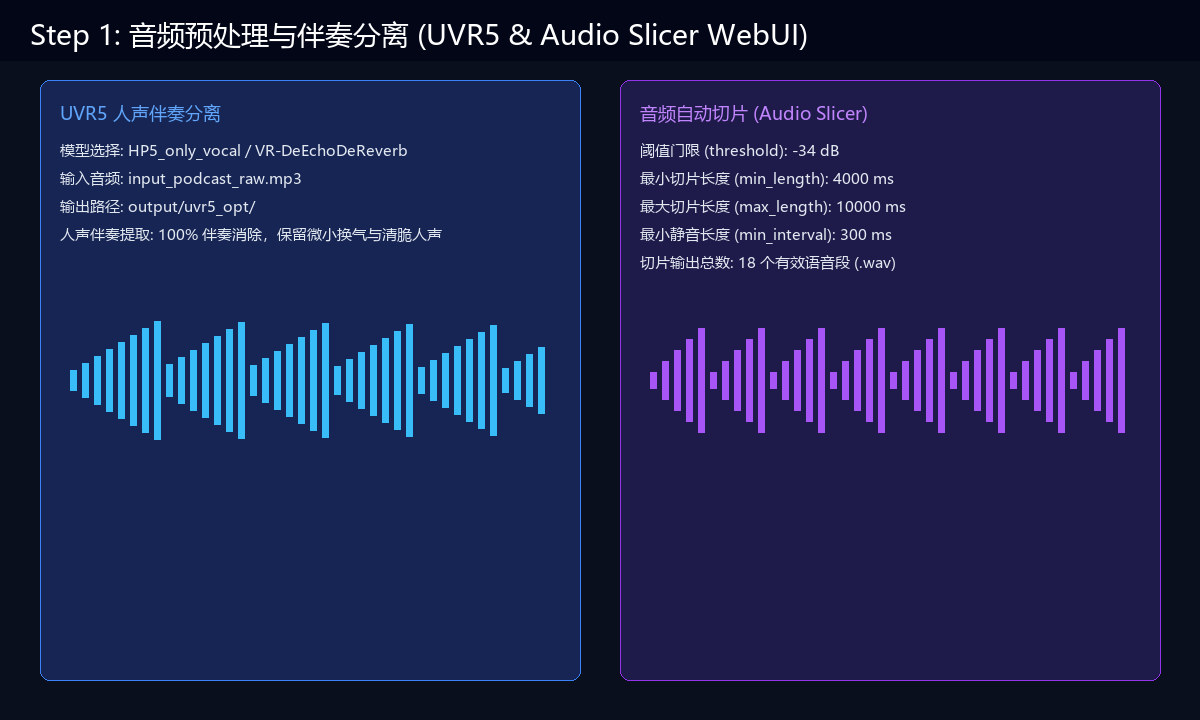
- UVR5 神经降噪与人声剥离:
- 如果你的素材是从播客、影视剧或视频中截取的,往往夹杂着微弱的背景音乐与环境底噪。
- GPT-SoVITS 原生集成了 UVR5(Ultimate Vocal Remover) 算法,只需选择
HP5_only_vocal或去混响模型,即可一键剔除 100% 伴奏与回声,精准提取纯净人声干音。 - Audio Slicer 智能切片:
- 设置静音门限阈值(默认
-34 dB)与最小静音间隔(300 ms),系统会自动将长音频按照自然呼吸停顿,切分成 4~10 秒的精简语音块,自动滤除空白无效片段。
步骤二:多语种 ASR 语音识别与自动打标(FunASR / Whisper)
切片完成后,过去需要人工逐条听写文本并制作标注文件,极其耗时;GPT-SoVITS 彻底实现了全自动化语音打标流水线。
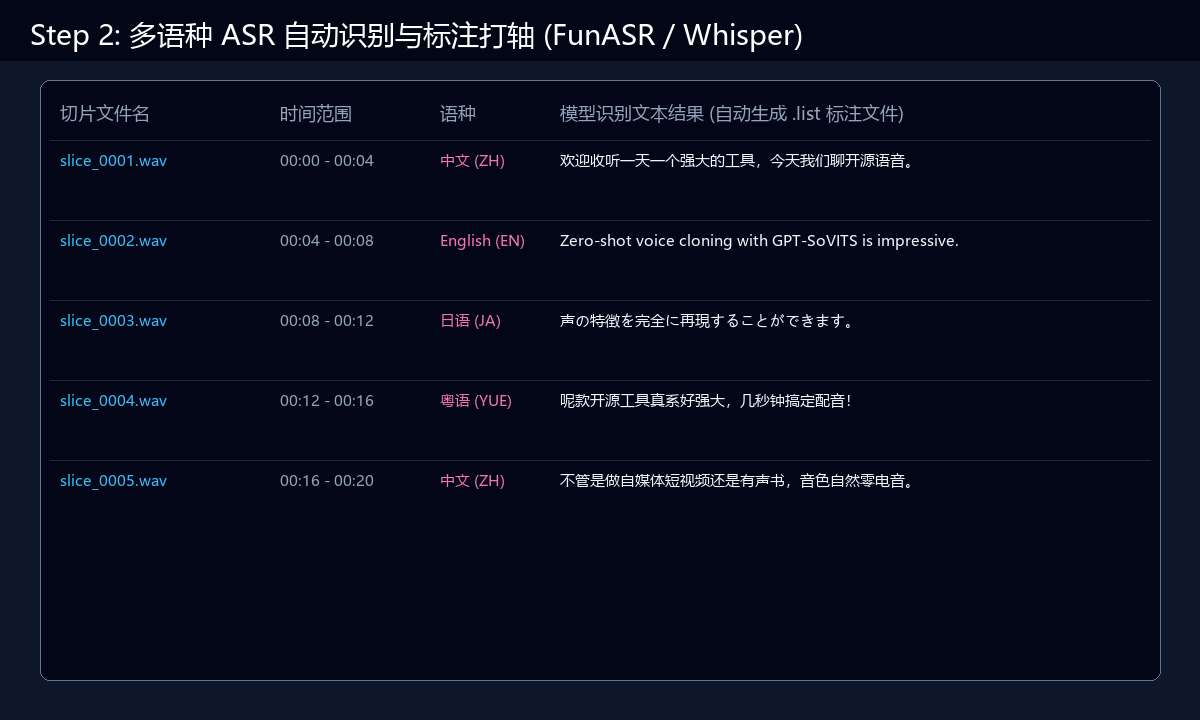
- 双引擎打标支持:支持阿里开源的 FunASR(针对中文普通话与方言识别精准度极高)和 OpenAI Whisper(国际通用强悍多语种模型);
- 语种涵盖:中文(ZH)、英语(EN)、日语(JA)以及粤语(YUE);
- 自动生成格式:识别完成后,自动将音频路径、说话人 ID、语种代码以及对应的文字内容整合为标准
.list训练集标注文件,免除一切手动排版繁琐!
步骤三:零样本极速微调与专属音色捕捉
拥有 1 分钟左右的标注数据集后,即可启动 GPT-SoVITS 极速微调。
- AR 模型微调(GPT 语义学习):负责学习目标说话人的语速节奏、句末升降调以及情感重音规律;
- SoVITS 模型微调(VITS 声学特征捕捉):基于变分自编码器(VAE)与归一化流(Normalizing Flow),精准捕获声带震动、共鸣腔体与发音颗粒感;
- 显存与速度优势:经过底层 LoRA 与显存优化,单张普通消费级显卡(如 RTX 3060 6GB/8GB 或更高)只需 10~15 分钟即可完成全部微调训练,Loss 迅速收敛至稳定状态。
步骤四:跨语种高保真语音合成(TTS 推理 WebUI)
训练完成后,即可打开极具现代化科技感的 TTS 推理控制台,开启属于你的 AI 声音工厂!
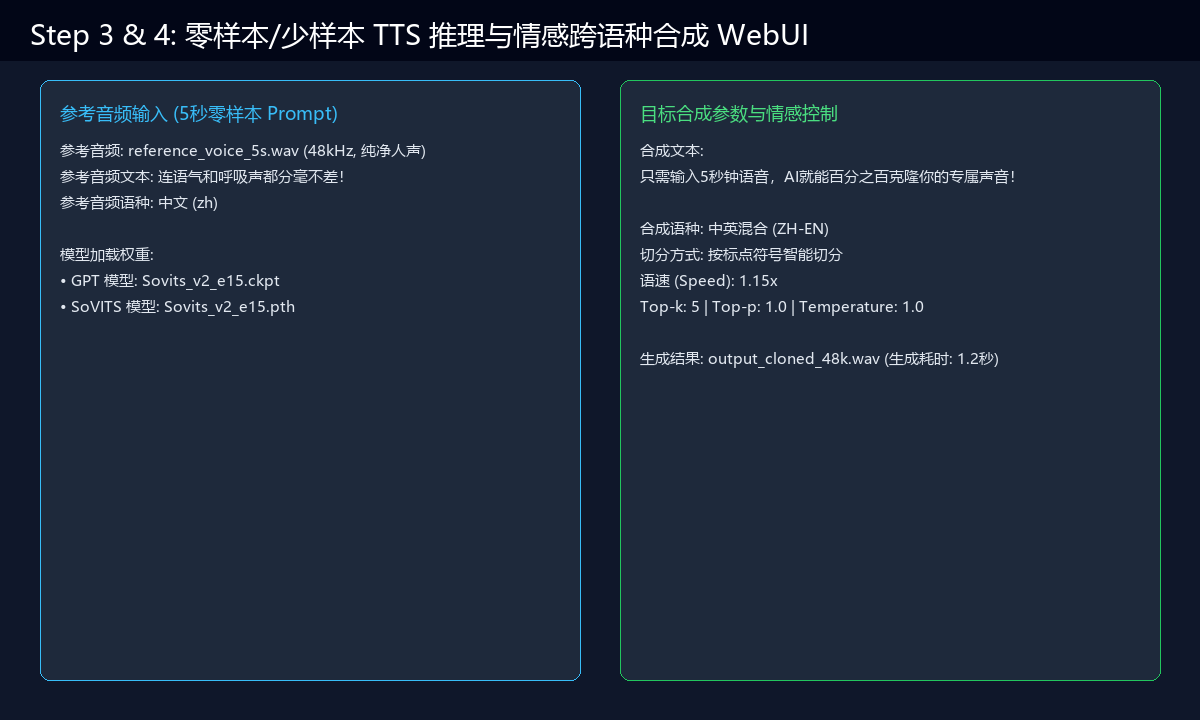
- 零样本(Zero-shot)即刻体验:
- 甚至无需提前微调模型,直接在推理面板中上传一段 5 秒的人声参考音频,输入参考音频对应的文本;
- 在下方“合成目标文本”框中敲入你想说的话,点击【立即合成】,模型即可直接进行音色迁移!
- 多情感与跨语种掌控:
- 原生支持欢快、激昂、沉稳、解说、深情等多种情感风格;
- 支持跨语种自由合成,让你用中文母语者的声音无缝演绎纯正地道的英文播报或日漫名台词。
三、硬件配置要求与本地部署指南
1. 硬件最低要求
- 显卡(GPU):NVIDIA 独立显卡(GTX 1660 6GB 以上即可运行;推荐 RTX 3060 / 4060 8GB 以上体验极速训练与毫秒级推理);
- 内存(RAM):16GB 及以上;
- 系统:Windows 10 / 11 64位,或 Linux (Ubuntu 20.04/22.04)。
2. Windows 用户一键整合包极速启动
针对不熟悉 Python 环境与 CUDA 驱动配置的新手用户,开源社区提供了完整的免安装整合包:
- 下载专属整合包后,解压至非中文纯英文路径(例如
D:\GPT-SoVITS-v2\); - 双击运行目录下的
go-webui.bat; - 程序会自动检测本地 GPU 驱动并在默认浏览器中弹出
http://127.0.0.1:9874控制台页面,即可直接上手!
3. Docker 容器化私有部署指令
对于运维人员或服务器开发者,推荐使用 Docker 一键容器化部署:
# 1. 拉取官方预构建完整镜像
docker pull breakstring/gpt-sovits:latest

# 2. 挂载本地模型与输出路径并启动容器
docker run -d --gpus all \
  -p 9871:9871 -p 9872:9872 -p 9873:9873 -p 9874:9874 \
  -v /data/gpt_sovits/models:/workspace/models \
  -v /data/gpt_sovits/output:/workspace/output \
  --name gpt-sovits \
  breakstring/gpt-sovits:latest
四、自媒体与商用场景调优实用排坑经验
- 如何彻底消除机械杂音与齿音?
- 录制 5 秒参考音频时,尽量使用电容麦克风或手机贴近录音,切勿开启过大的数字增益;切片阶段务必勾选 UVR5 伴奏分离,彻底过滤高频刺耳噪音。
- 合成声音语速过快或吞字怎么办?
- 检查切分选项,推荐选择“按中文句号/感叹号切分”;同时可微调
Speed参数为1.0~1.15,Top-k保持在5~10,能够大幅提升长句播报的稳健度。 - 跨语种发音如何更加纯正?
- 如果用中文声音克隆英文,参考音频建议选用中英混杂句或音素覆盖度较高的语句,帮助模型学习跨语言音素对齐矩阵。
五、资源获取与整合包下载
为了方便广大创作者与技术开发者开箱即用,已将 GPT-SoVITS 官方最新版 Windows 一键整合包、常用高品质预训练音色权重与保姆级实操视频教程 整理收录至专属技术资源站:
- 打开浏览器进入【杂乱资源网】官方站点:
https://srcs.hei-ai.com/- 在全站搜索框输入关键字:
gptsovits- 即可直接免费获取全套免配置整合包、官方依赖环境与实战工作流教程!
