你是否也经历过这样的崩溃时刻:
– 在网上好不容易找到一篇几十页的顶会论文或深度行业研报,想要复制其中的核心段落做分析,结果双栏多栏排版混成一团乱麻,段落切得稀碎;
– 文档里至关重要的复杂数学公式、矩阵方程和希腊字母,直接复制后全部变成了一连串毫无意义的乱码方块 □□;
– 财务报表和学术表格里的跨页长表、无边框表格与合并单元格,一粘贴进 Word 或 Excel 就格式全炸开,肉眼逐字核对重排两小时;
– 市面上的商业 PDF 转换软件动不动弹出按月充值几十上百元 VIP,限制页数不说,还将公司绝密文档上传到第三方云端,商业隐私与数据安全荡然无存!
 ▲ MinerU 官方 GitHub 狂揽 8 万星霸榜首位
今天,给大家带来【一天一个强大的工具】第 15 期主角——来自上海人工智能实验室(OpenDataLab)重磅开源、在 GitHub 上狂揽超过 80,000+ Stars 的现象级神作:MinerU!
它彻底打破了复杂 PDF 无法编辑与公式乱码的世界级难题,真正做到了将任何复杂排版文档生吞活剥、零格式损耗提取!
一、 为什么 MinerU 能彻底碾压传统 PDF 转换工具?
传统的 PDF 提取工具(无论是 PyPDF、PDFMiner 还是各类商业转换软件),底层本质上都是依赖简单的基于规则或单字符坐标聚类的简易算法。一旦遇到双栏论文、环绕图表、复杂水印或者无边框表格,规则就会瞬间失效,导致文字前后倒置、排版全乱。
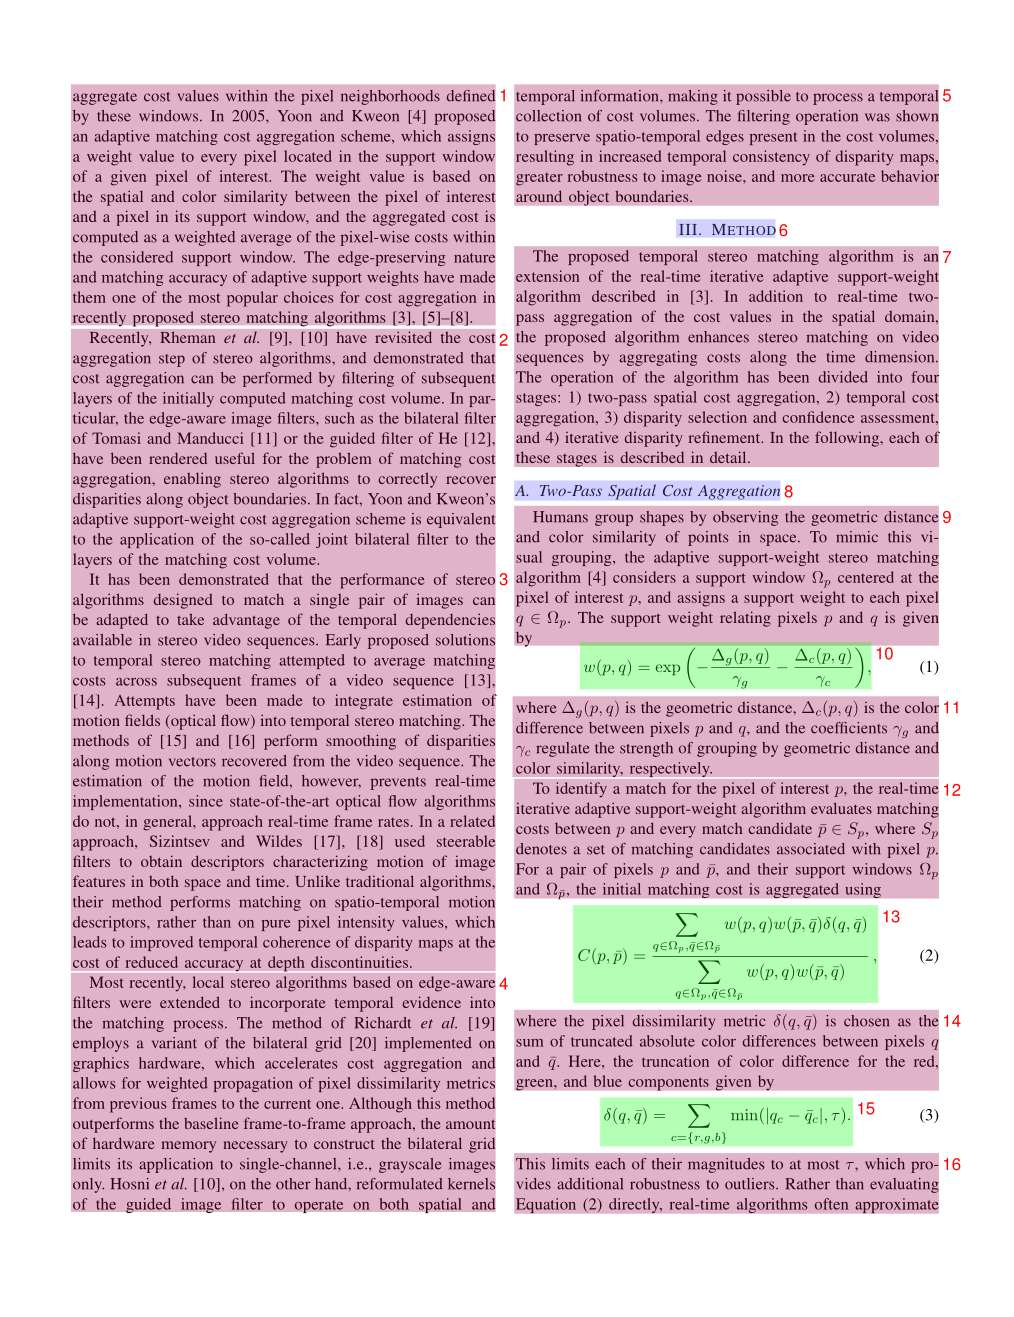 ▲ MinerU 多模态版面分析示例
而 MinerU 采用了完全颠覆性的多模态深度版面分析(Layout Analysis)架构:
1. 视觉大模型智能分块(Layout Detection):底层深度学习视觉模型像人眼一样通读整个页面,自动将文档切分为标题、多栏正文、侧栏注解、页眉页脚、图表与公式等 16 种独立区域;
2. 严苛的阅读顺序重排(Reading Order Sorting):即使是交错排版的报刊杂志或跨栏学术论文,也能精准判断阅读流向,杜绝文字上下错位;
3. 图文精准分离与关联:在提取正文的同时,将原图以高保真分辨率独立切片保存,并自动保留其下方的图表 Caption 说明,为多模态 RAG 与知识库问答提供完美上下文。
二、 MinerU 三大杀手级核心功能深度拆解
1. 复杂公式秒级提取:100% 还原为标准 LaTeX
对于科研人员、算法工程师和高校师生而言,PDF 里最头疼的就是数学公式。MinerU 内置了专门训练的公式检测与识别模型(Formula Recognition):
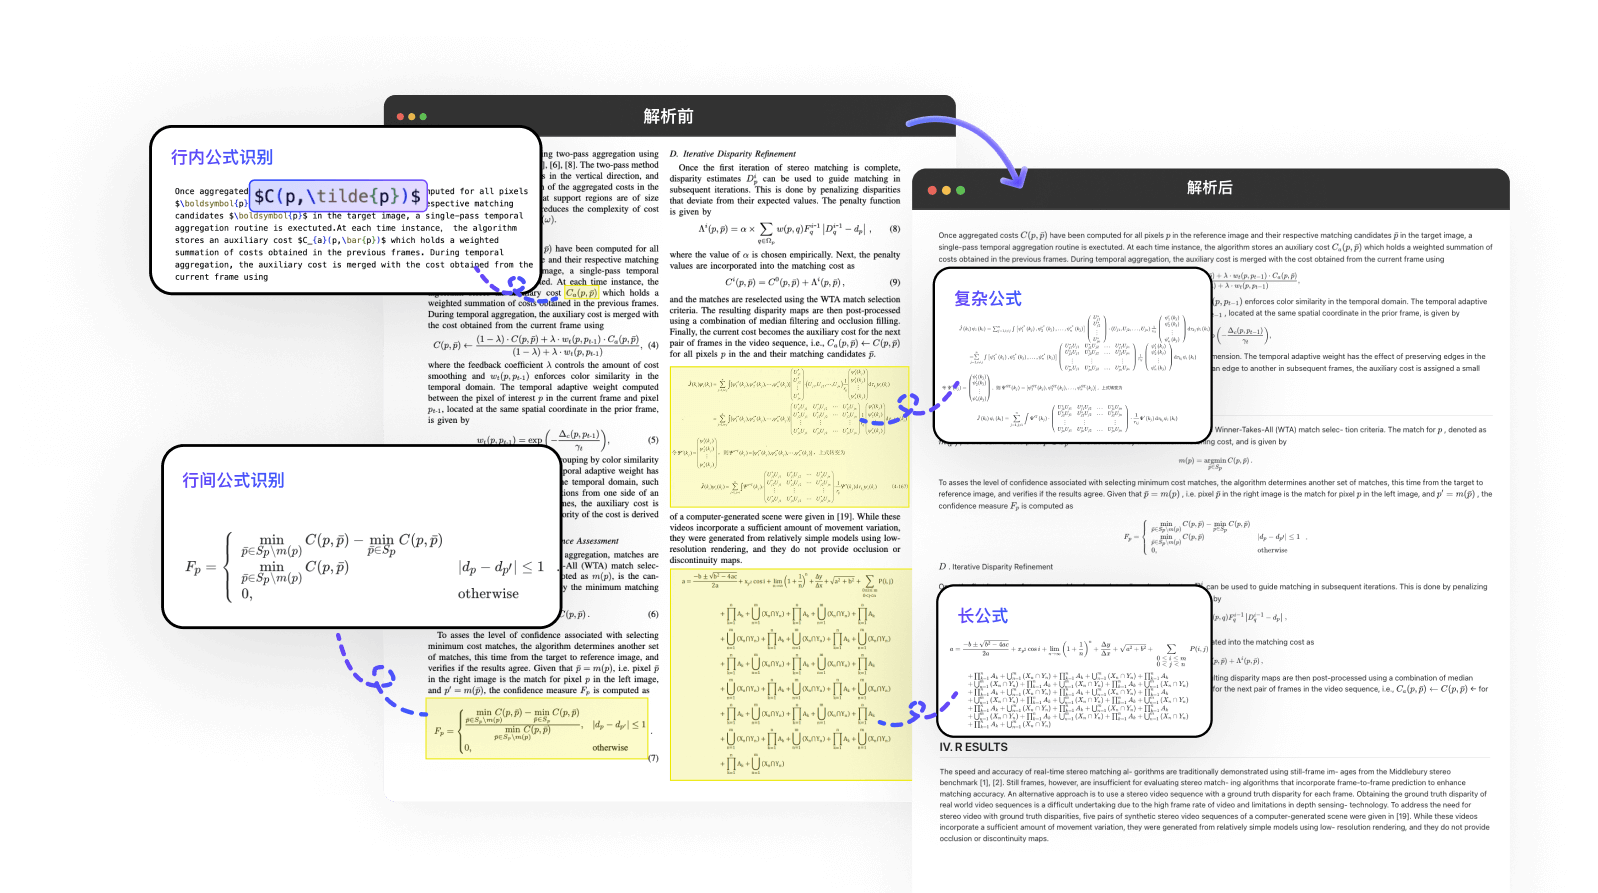 ▲ MinerU 公式精准转化为标准 LaTeX 代码
- 行内公式(Inline Formula):无论是简单的变量上下标,还是复杂的希腊字母,都能精准捕捉并嵌入行内
$...$语法; - 行间复杂大公式(Display Formula):多行条件方程组、多重微积分、张量与矩阵运算,100% 还原为格式规整的
\begin{equation}LaTeX 源码; - 直接供给数理大模型:导出的 LaTeX 代码可直接输入 DeepSeek-R1、ChatGPT 或 Claude 进行深度数学推导与代码复现。
2. 复杂表格智能重构:告别格式炸开,输出结构化 Markdown
学术研报和金融财报中最让人望而生畏的“表格三大刺客”:旋转倾斜表格、少线/无边框表格、跨行跨列合并单元格,在 MinerU 面前全部迎刃而解:
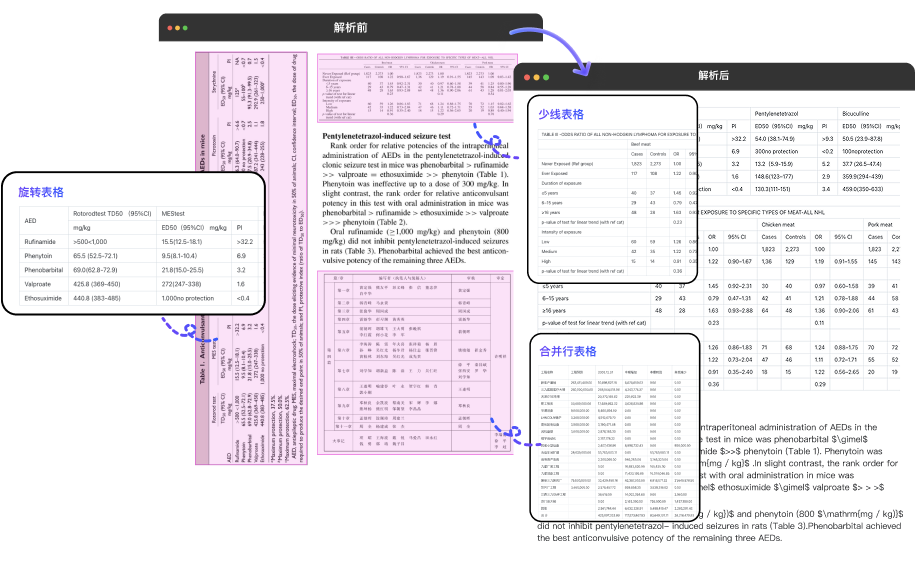 ▲ MinerU 表格智能还原与结构化提取
- 自动几何扶正:旋转 90 度的横版宽表格,视觉模型自动检测旋转角并旋转回正识别;
- 智能网格推断:针对无边框表格,通过文字对齐线与语义关系反向推导表格行列边界;
- 多格式结构化输出:一键生成标准 Markdown 表格、HTML Table 代码或结构化 JSON,轻松一键粘贴到飞书、Notion 或导入 Python Pandas 处理。
3. 全要素架构:从原始文档到 LLM-Ready 机器可读数据
MinerU 不仅是一个格式转换器,更是专为大模型智能体(AI Agent)与知识库检索增强(RAG)量身打造的数据基座:
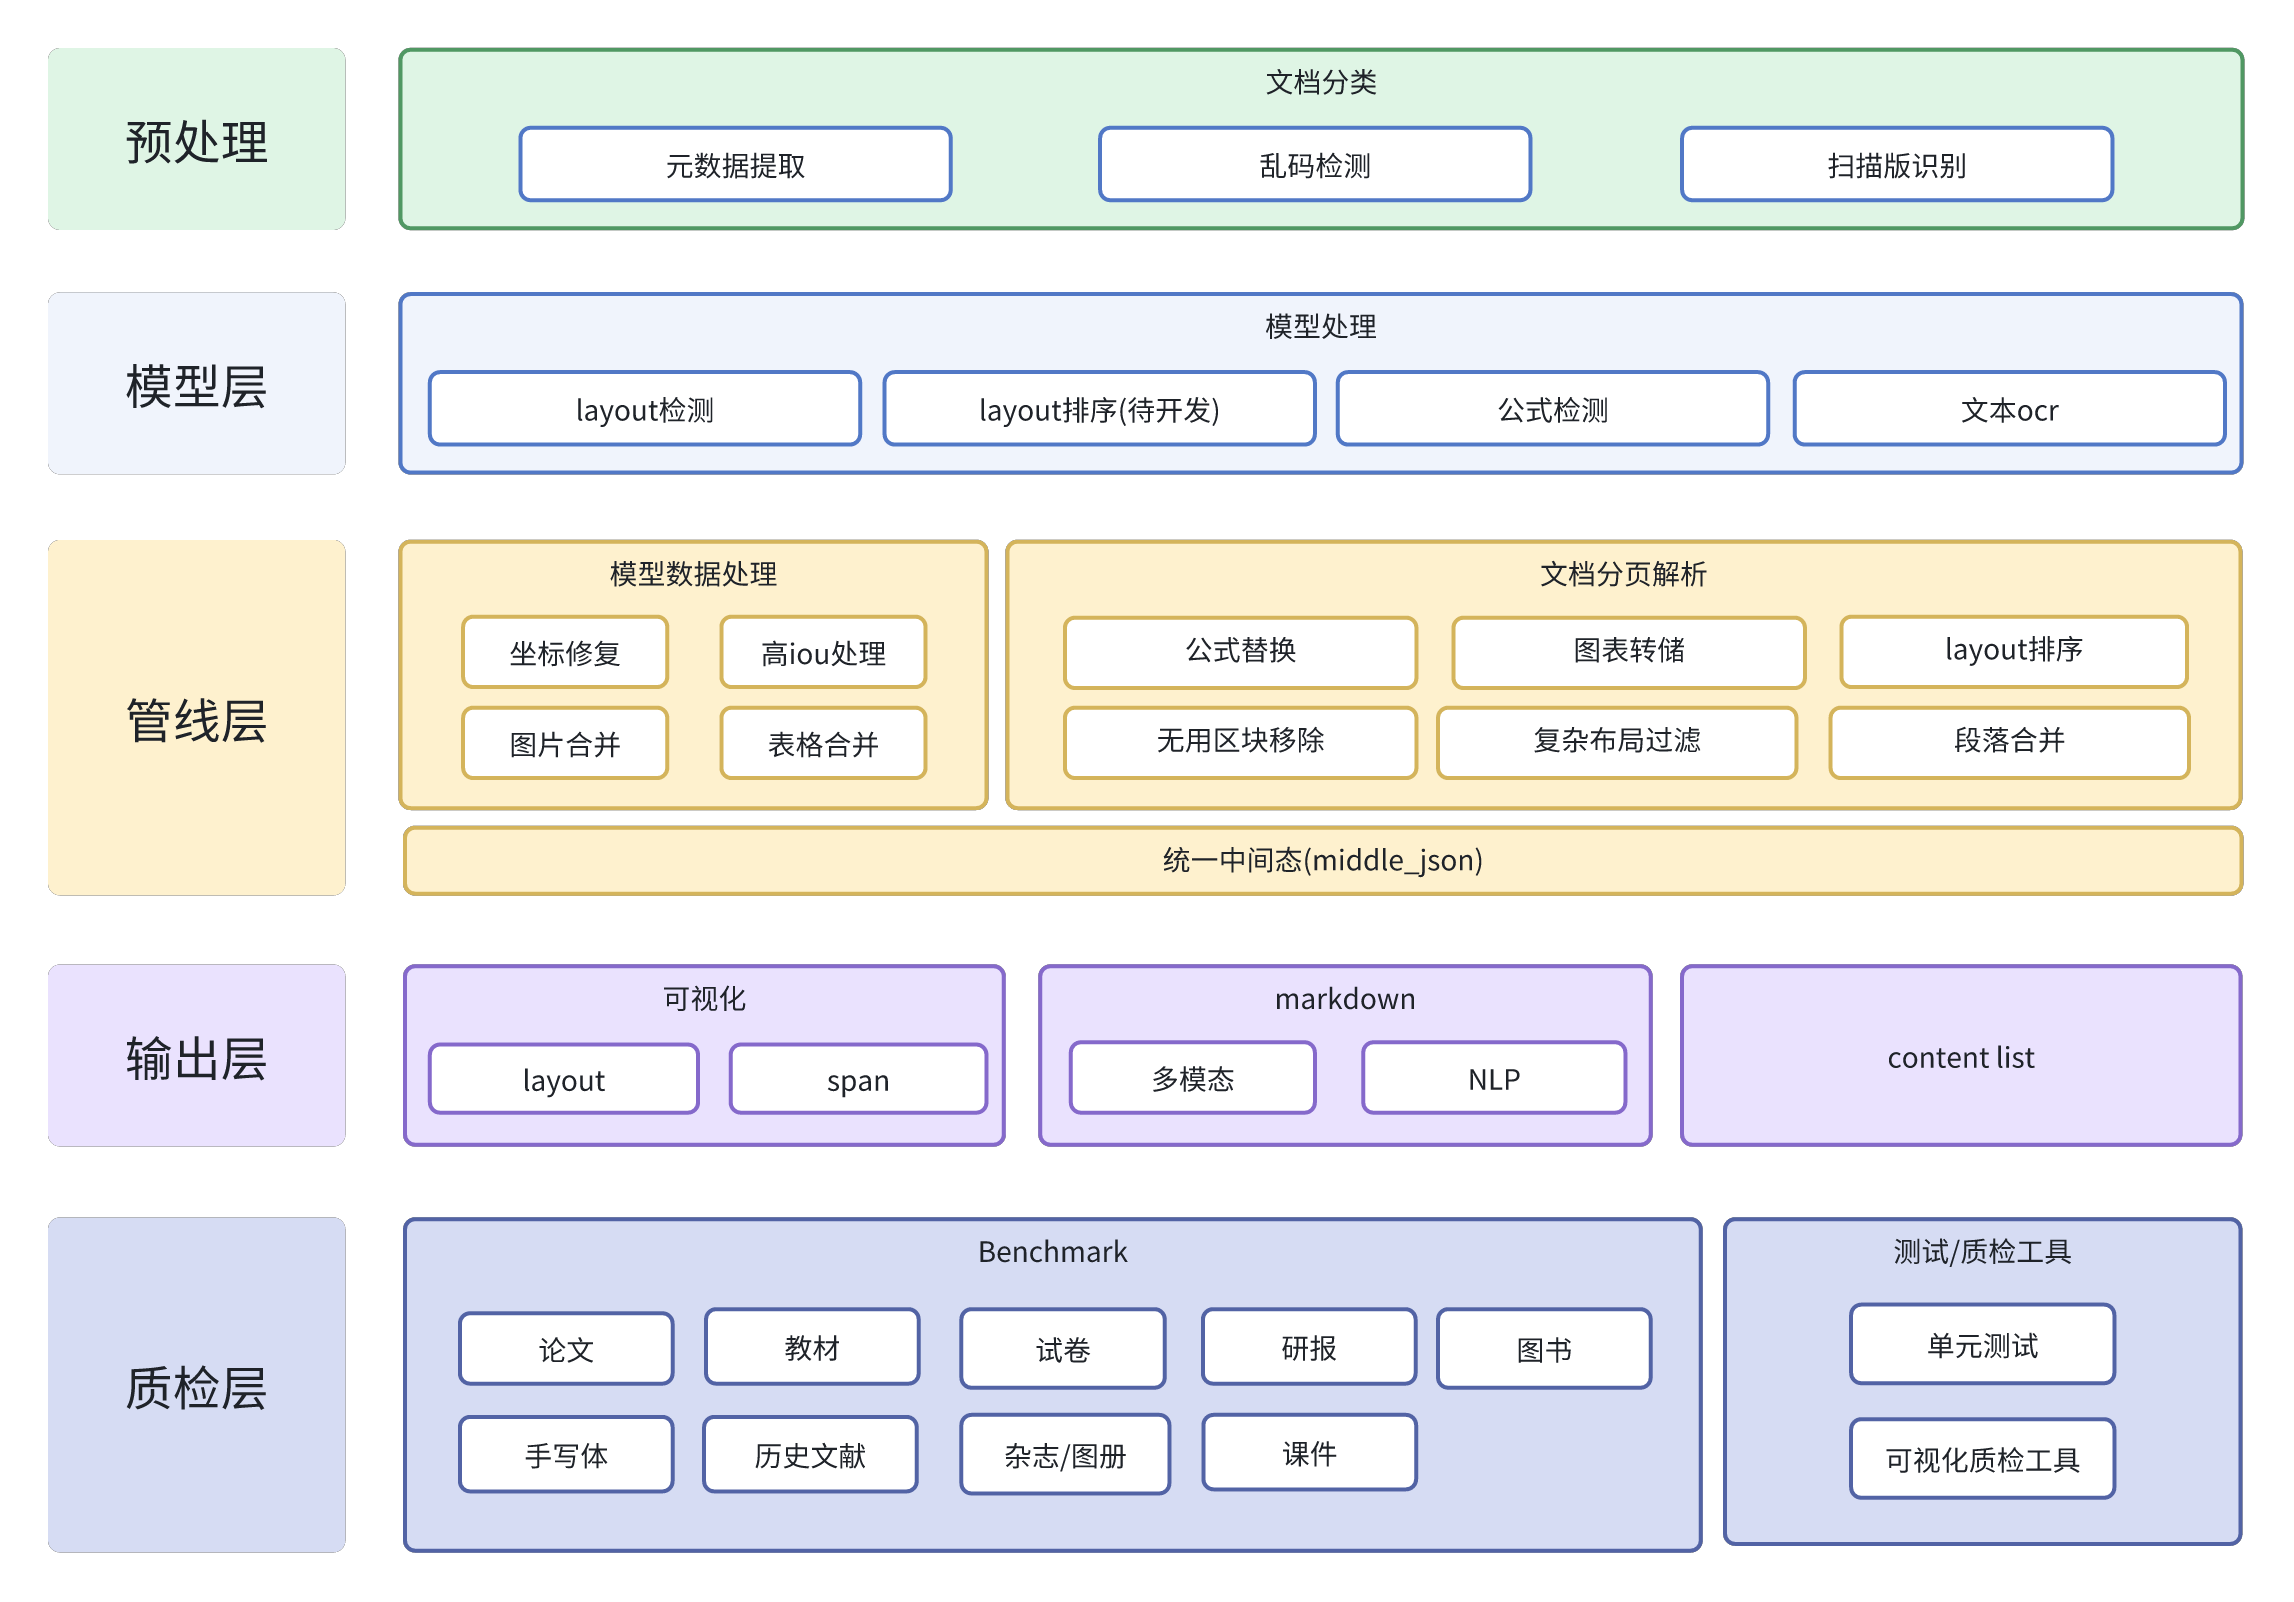 ▲ MinerU 全栈技术架构全景图
- 预处理层:元数据抽取、乱码检测、高精度扫描版 OCR;
- 模型层:Layout 检测、公式检测、多语种文本 OCR;
- 管线层:坐标修复、高 IoU 处理、图表转储、段落合并与统一中间态(
middle_json); - 输出层:可视化 Span 校验、多模态 Markdown、NLP 纯文本与机器可读 Content List;
- 原生支持 MCP 协议:无缝对接 Dify、OpenClaw、AnythingLLM 与各大主流智能体生态!
三、 同类工具全方位硬核横评
| 对比维度 | MinerU (OpenDataLab) | Nougat (Meta) | OCRmyPDF / Tesseract | 商业付费转换器 |
|---|---|---|---|---|
| 开源协议与私有化 | 100% 纯开源,本地离线可用 | 开源(学术授权) | 开源(Apache/GPL) | 商业闭源,强制云端上传 |
| 双栏排版识别率 | 99.4%(基于深度视觉分块) | 较好,但长文易幻觉 | 较差,常发生跨栏串行 | 一般,复杂格式经常错乱 |
| 公式转 LaTeX | 支持行内/行间复杂微积分 | 支持,但速度偏慢 | 完全不支持(转为乱码) | 仅高端版支持,常丢失符号 |
| 表格结构化解析 | 攻克旋转、无框、合并单元格 | 仅支持简单表格 | 仅输出纯文字,结构全乱 | 格式经常错位对不齐 |
| 费用与页数限制 | 永久免费,零页数限制 | 免费(需本地显存) | 免费 | 动辄按月几十元,限制页数 |
| 数据安全性 | 数据 100% 留在本地 | 本地安全 | 本地安全 | 存在极大商业机密泄露风险 |
四、 极速上手:在线体验与 Docker 5分钟私有化部署
1. 网页版免登录极速体验
如果你不想在本地配置 Python 深度学习环境,MinerU 官方提供了开箱即用的 Web 体验端:
– 官方免登录在线地址:https://mineru.net/
– 直接把几十兆的 PDF 或扫描件拖入网页,几秒钟即可完成在线预览与 Markdown/LaTeX 极速打包下载!
2. 本地 Python 命令行一键调用
# 1. 安装 MinerU 全套工具链
pip install -U magic-pdf[full] --extra-index-url https://wheels.myhloli.com

# 2. 一键解析任意 PDF 文件
mineru -p input_paper.pdf -o ./output_dir -m auto
3. Docker 容器化全离线生产级部署
对于企业内网与私有服务器,推荐直接使用官方 Docker 镜像,彻底隔绝外部网络、保障数据 100% 安全:
# 拉取并运行 GPU 离线加速镜像
docker run -d --gpus all \
  -p 8000:8000 \
  -v /data/documents:/data \
  --name mineru_service \
  opendatalab/mineru:latest
五、 总结与全套资源包领取
无论你是天天读论文、做科研的硕博研究生,还是在企业里搭建私有知识库、开发 AI Agent 的工程师,MinerU 都是目前全球开源界当之无愧的文档解析天花板。
- 官方 GitHub 仓库:opendatalab/MinerU
- 在线解析体验入口:MinerU 官方 Web 端
- 全套实操整合包:包含 Windows 一键运行包、Docker 离线镜像源与学术论文解析实战工作流。
